Suivre l'élection québécoise de 2026 avec SearchAPI sur les services Google et ChatGPT
Note : Cette version française a été générée par Claude Sonnet 5 (claude-sonnet-5) le 28 septembre 2026. La version originale en anglais est disponible ici.
TL;DR : J’ai passé les dernières semaines à pointer SearchAPI sur l’élection québécoise de 2026, Google, ChatGPT et Gemini inclus, et j’en ai tiré trois choses avec lesquelles vous pouvez jouer dès maintenant : le code, le rapport en direct, et le dataset.
Cet été, en travaillant sur de l’optimisation et de la réactivation de pipelines de données, j’ai relancé un de mes projets récurrents : la collecte de données liées à l’élection présidentielle française de 2027 (quelque chose que j’avais déjà fait en 2017 et 2022). Pendant que j’y travaillais, deux choses se sont produites en même temps :
- En tant que citoyen canadien récent, je peux maintenant voter, et une élection approche à grands pas : l’élection générale du Québec le 5 octobre, où chaque circonscription élit un membre de l’Assemblée nationale, et la majorité qui en résulte détermine le premier ministre du Québec.
- J’ai été contacté par SearchAPI pour tester leur API et écrire un article à ce sujet (salut Sam Gale 👋).
Alors pourquoi ne pas combiner les deux, et utiliser SearchAPI pour construire un dataset public et quelques analyses autour de l’élection québécoise à venir ?
PS : Ceci est un article sponsorisé par SearchAPI, donc toutes les opinions et tous les avis sur le service représentent uniquement mon point de vue personnel, pas celui de mon employeur actuel, Ubisoft.
C’est quoi cette élection ?
Le but de cette élection, qui se tient le 5 octobre, est d’élire le nouveau gouvernement en choisissant le membre de l’Assemblée nationale pour chacune des 127 circonscriptions électorales du Québec. Le parti politique qui détient la majorité des sièges peut proposer son chef comme premier ministre du Québec.
Le poste est occupé depuis 2018 par François Legault, qui a dirigé la CAQ avant de démissionner au début de 2026. Un changement notable cette année est que le nombre de sièges est passé de 125 à 127, ce qui veut dire qu’un parti a maintenant besoin de 64 sièges pour obtenir la majorité. Les prédictions actuelles pointent vers un gouvernement minoritaire, c’est-à-dire qu’aucun parti n’atteindrait ces 64 sièges nécessaires pour faire passer son programme sans opposition.
Les principaux chefs de parti actuels sont :
- Christine Fréchette - Coalition Avenir Québec (CAQ)
- Ruba Ghazal - Québec Solidaire (QS)
- Charles Milliard - Parti libéral du Québec (PLQ)
- Éric Duhaime - Parti conservateur du Québec (PCQ)
- Paul St-Pierre Plamondon - Parti Québécois (PQ)
Pour commencer à plonger dans ce projet, je voulais trouver des données officielles qui m’aideraient à mieux comprendre comment les circonscriptions sont découpées. J’ai eu de la chance ici : en plus d’avoir un site web très propre qui explique l’élection et présente de l’information générale, le Québec fournit aussi une section de données ouvertes où on peut obtenir les résultats le soir de l’élection, ainsi que des détails sur les candidats et les électeurs de chaque circonscription.
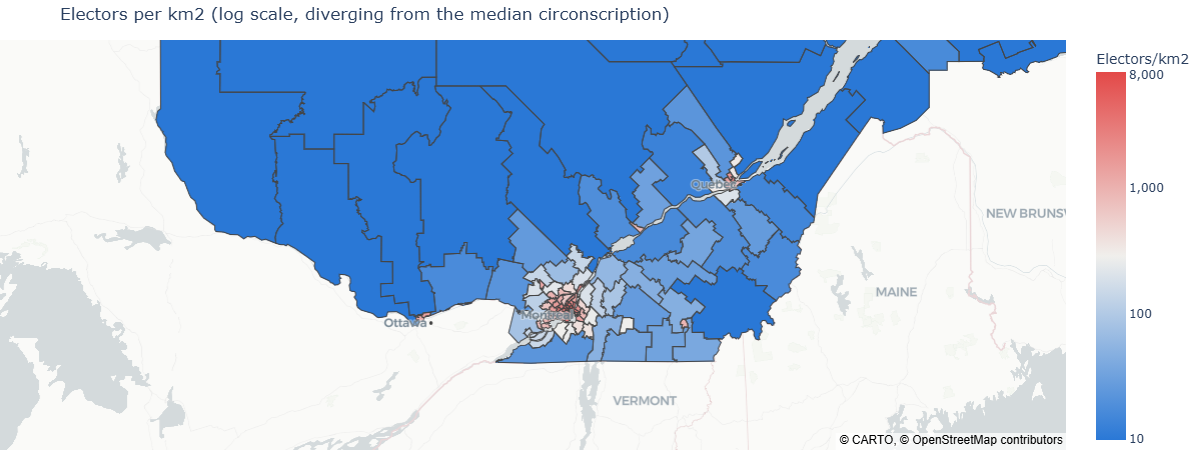
On voit clairement que les grands centres urbains comme Montréal ont une concentration beaucoup plus élevée que les régions plus rurales.
Au-delà de l’élection elle-même, il y a une particularité du Québec et du Canada en général que je voulais souligner. Le Canada est un pays multilingue, et certaines provinces ont leur propre langue officielle : le Nouveau-Brunswick, par exemple, est la seule province officiellement bilingue, avec le français et l’anglais, alors que le Québec est unilingue français sur papier, même s’il compte encore une communauté anglophone importante. C’est pour ça que je voulais que mes requêtes et mes recherches captent à la fois l’influence anglophone et francophone.
Maintenant, essayons de collecter des données en ligne sur la façon dont les différents partis sont perçus, et c’est là que SearchAPI entre en jeu.
SearchAPI à la rescousse
SearchAPI est une API de SERP (search engine results page) en temps réel : plutôt que de scraper Google, Bing, YouTube, ou plus de 70 autres moteurs de recherche et sources de données vous-même, vous appelez leur API REST et récupérez du JSON structuré et prêt à l’emploi, avec les résultats organiques, les publicités, les knowledge graphs, les « People Also Ask », et plus encore. Ils s’occupent des parties pénibles qui rendent le scraping maison désagréable, comme la rotation de proxys et la résolution de CAPTCHA, donc vous récupérez vos résultats en moins de deux secondes avec un taux de succès de 99,9 %. C’est pensé pour quiconque construit des outils qui dépendent de la recherche : équipes SEO, chercheurs en IA/ML, gens de la veille concurrentielle, et, comme quoi, des dataguys qui collectent des données électorales.
Il y a donc deux choses que je voulais explorer avec les endpoints :
- Interroger différents types d’information (selon le service) : je voulais voir, autant au niveau du parti qu’au niveau du chef de parti, à quoi ressemblait le contenu global pour ces deux entités.
- Tester aussi différentes langues : comme le français et l’anglais cohabitent au Québec, c’était aussi important pour moi de voir comment ces services se comportent dans les deux langues.
Voici une vue d’ensemble du workflow que j’ai construit avec AWS pour automatiser la collecte de données sur une base quotidienne. J’ai aussi ajouté un export vers Kaggle, que je fais manuellement pour l’instant. Le tout, collecteurs, traitement et code d’analyse, se trouve dans le dépôt GitHub construit pour l’occasion, donc n’hésitez pas à fouiller si vous voulez voir comment c’est assemblé.
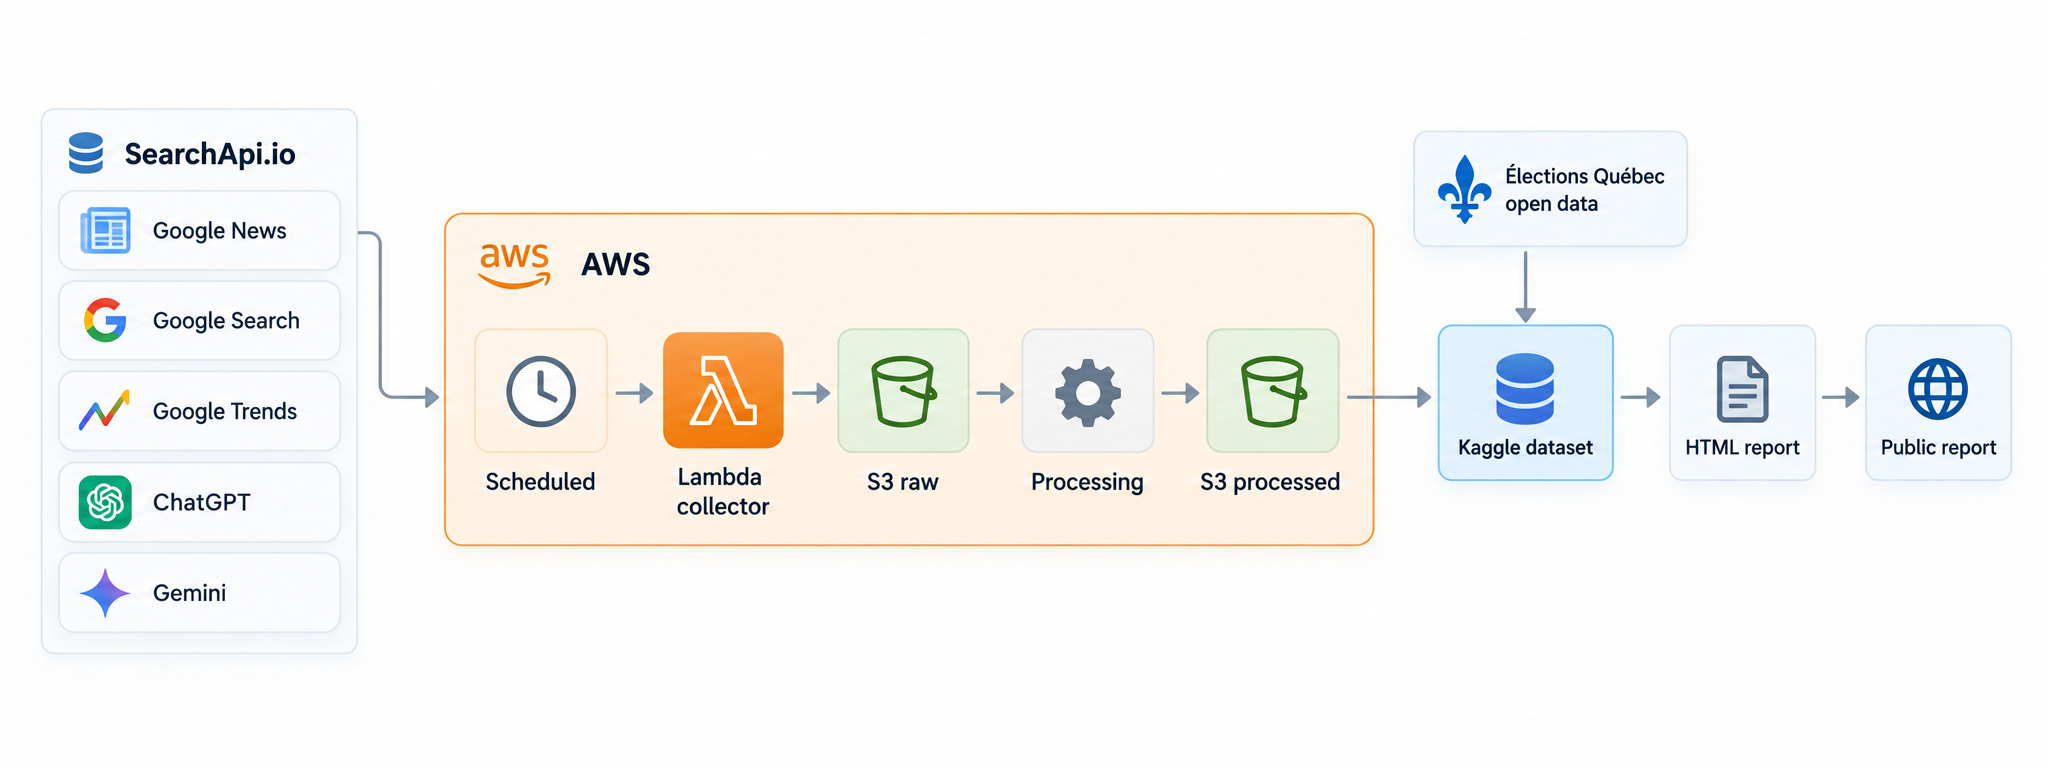
L’objectif de cette collecte est de rassembler des données provenant de Google News, Google Trends et ChatGPT/Gemini. Les deux premières sources sont des choix assez évidents, mais pour la dernière, je voulais aussi avoir une idée de ce qu’un agent comme Gemini ou ChatGPT retourne lors d’une recherche web pour des questions précises.
Alors plongeons d’abord dans la collecte de données de Google.
Les graphiques que vous verrez dans les sections suivantes ont été construits le 27 septembre 2026. Pour la version la plus à jour, jetez un œil au rapport en direct.
Google News et Google rank
SearchAPI offre la possibilité de collecter de l’information à partir de services Google comme Google News ou directement les résultats de recherche Google.
Il y a deux endpoints que j’ai utilisés pour interagir avec Google News et le classement des résultats de recherche sur Google.
Google News endpoint collection
En arrière-plan, ça appelle le moteur google_news (docs). Paramètres clés : q pour la requête (dans mon cas, le nom du parti ou du chef de parti), gl et location pour rester centré sur le Québec/Canada, et hl/lr pour la langue, que j’alterne entre fr/lang_fr et en/lang_en selon la requête pour obtenir le paysage médiatique français et anglais pour le même parti.
Avec Google News, on peut facilement obtenir une vue du nombre d’articles de presse retournés pour un parti donné.
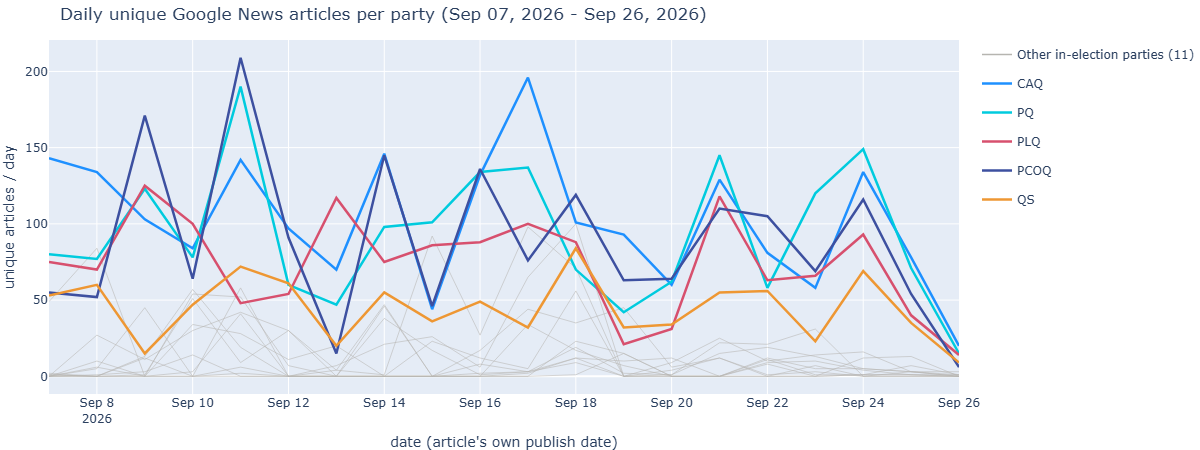
On remarque une nette dominance des 5 principaux partis, mais certains des plus petits partis grimpent parfois près du niveau de Québec Solidaire. La couverture est bruitée au jour le jour, mais l’écart entre les grands partis et les autres se maintient sur les trois semaines complètes.
Au-delà de Google News, il est aussi intéressant de regarder les domaines qui se classent le mieux quand on cherche la requête : les résultats reviennent avec un ordre clair, donc ils sont faciles d’accès.
Google rank of search results
Celui-ci tourne sur le moteur google_rank_tracking (docs). Mêmes paramètres que Google News (q, gl, location, hl/lr), plus num, qui récupère jusqu’à 100 résultats organiques classés (position, domaine, lien, titre, extrait) en un seul appel plutôt que de paginer 10 à la fois.
Avec ça, on peut facilement regarder les pages les mieux classées et analyser quels domaines sont liés à un parti ou un chef. Voici un aperçu du domaine qui occupe le résultat organique n° 1 pour chacun des 16 chefs de parti :
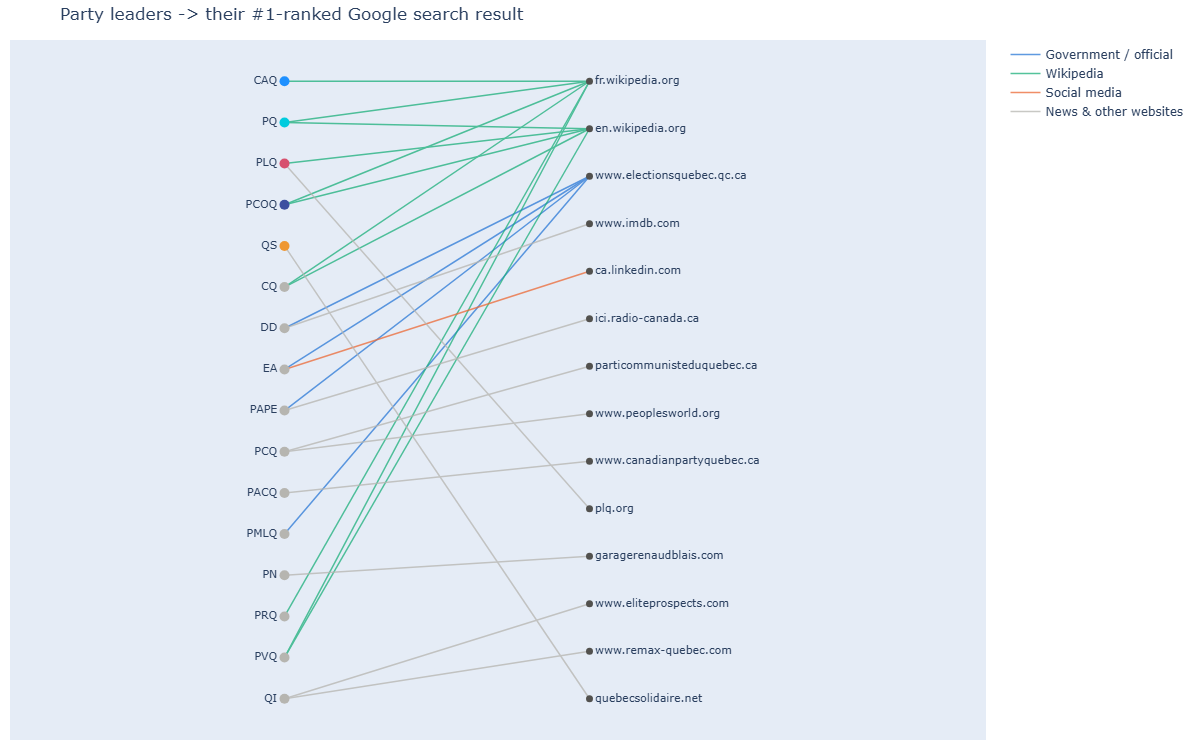
Wikipédia (vert) occupe la première place pour la plupart des chefs principaux. Les versions française et anglaise reviennent toutes les deux régulièrement. Quelques petits partis voient plutôt le site officiel d’Élections Québec prendre la première place, et seule une poignée échappe complètement au motif Wikipédia/gouvernement, en renvoyant vers un site comme IMDb (le chef du parti DD est animateur de balado) ou un site homonyme sans lien (comme celui de Remax).
C’est un endpoint vraiment pratique si vous voulez collecter de l’information sur un sujet précis et voir comment ça évolue dans le temps (parfait pour de la veille technologique ou pour étudier vos propres retours de données).
Plongeons maintenant dans la partie la plus intéressante de Google : les tendances.
Google Trends
Avec Google Trends, on peut se concentrer sur une requête précise et voir comment elle évolue, ou collecter les tendances pour un endroit précis. Pour cet article, comme on peut s’y attendre, j’ai décidé de me concentrer sur la région CA-QC et d’en extraire les tendances.
Pour les tendances du moment, voici ce qu’on peut faire :
Trending now
Celui-ci est un peu à part : il ne se base pas du tout sur une requête. google_trends_trending_now (docs) prend juste un geo (j’utilise CA-QC) et une fenêtre time (past_24_hours, past_48_hours, ou past_7_days), et retourne tout ce qui est actuellement tendance à cet endroit. C’est plus un outil de découverte qu’un outil qu’on pointerait sur un parti précis. Par exemple, voici une représentation de ce qui est actuellement le plus populaire au Québec :
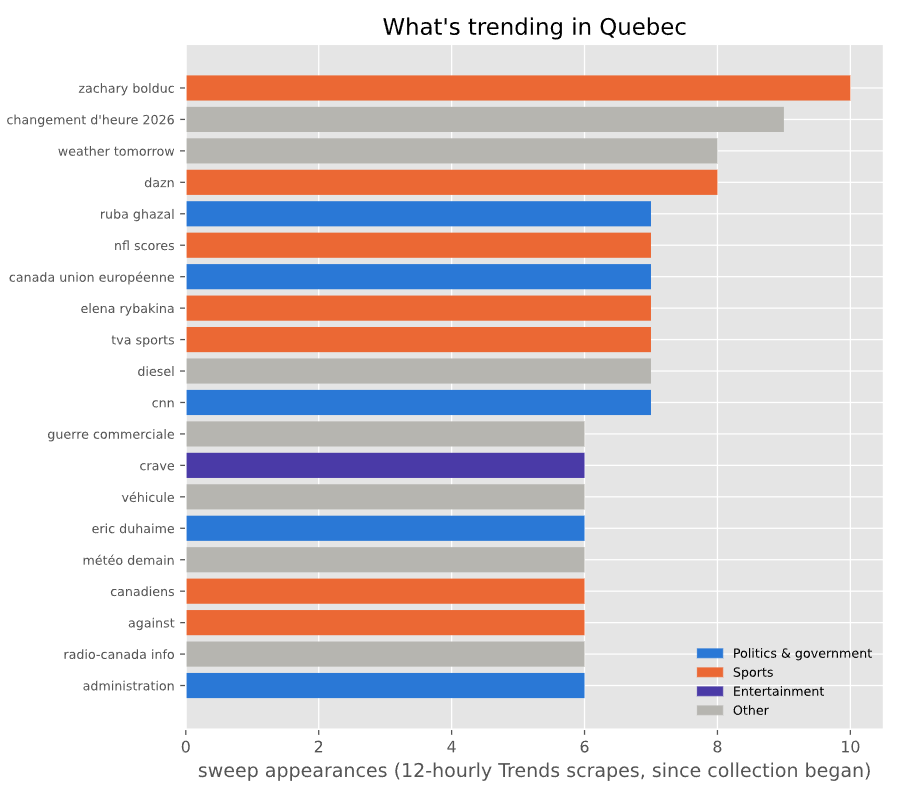
La politique ne domine pas les tendances générales de recherche au Québec. Le sport, la météo et les termes liés au streaming occupent la plupart des premières places. Cela dit, des noms de chefs comme Ruba Ghazal et Éric Duhaime réussissent quand même à se faufiler dans la liste, donc l’élection fait clairement partie du mélange de recherches du quotidien, juste pas la plus grosse partie.
Google Trends offre plusieurs options, mais la plus intéressante semble toujours être de faire des comparaisons avec cet endpoint :
Trends endpoints
Pour tout le reste, c’est le moteur google_trends (docs), où le paramètre principal est data_type :
TIMESERIESpour l’intérêt dans le temps (jusqu’à 5 termes séparés par des virgules sur une échelle partagée, donc les 5 partis peuvent aller dans un seul appel),RELATED_QUERIES,RELATED_TOPICSpour ce que les gens recherchent autour d’un terme donné,GEO_MAP(avecregion) pour décomposer l’intérêt par région plutôt que dans le temps.
Une chose à surveiller : les valeurs de TIMESERIES sont des indices relatifs, recalculés à chaque requête, donc elles ne sont comparables qu’à l’intérieur d’un même appel q séparé par des virgules, pas entre des appels différents. On ne peut pas comparer l’intérêt de requêtes individuelles entre différents appels ; si on a besoin d’une comparaison, elle doit se faire dans le même appel API (5 termes maximum).
Pour définir les tendances, il faut aussi préciser la période qui vous intéresse. Il y en a des prédéfinies comme today 3-m, mais on peut aussi en configurer une personnalisée si on veut se concentrer sur une période plus récente, etc. (soyez tout de même prudents, car la notion d’« intérêt » peut changer selon la période choisie).
Avec cette information, on peut facilement se faire une idée, par exemple, de l’évolution de l’intérêt dans le temps pour les cinq principaux partis.
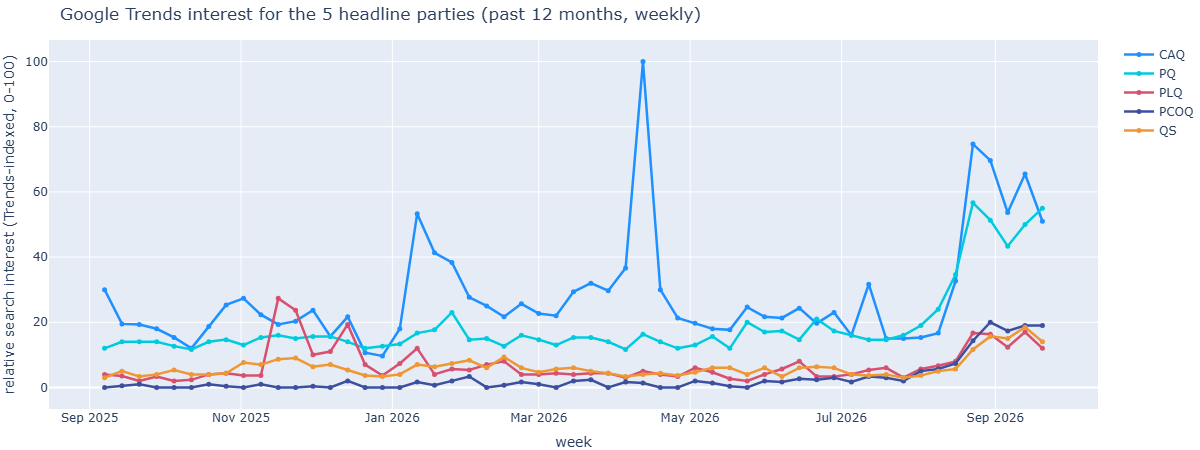
On voit clairement, pour la CAQ, un pic au début juin quand Legault a quitté son poste de premier ministre, et un autre en avril 2026, durant la semaine où le nouveau chef de parti a été élu. Au-delà de ces deux événements, la CAQ et le PQ grimpent tous les deux fortement à partir de la fin de l’été 2026 alors que la campagne s’intensifie, tandis que le PLQ, le PCOQ et QS restent relativement stables toute l’année.
Passons maintenant à l’aspect « agent » de cette veille politique.
ChatGPT
Les agents conversationnels comme ChatGPT et Gemini sont en train de devenir le nouveau « Google », puisqu’ils sont assez pratiques pour chercher de l’information en ligne, avec la capacité d’accéder au web pour aller vérifier les choses. Je voulais donc explorer comment observer les réponses fournies par ces systèmes une fois connectés au web.
Pour ça, je voulais aller un peu plus loin que juste poser des questions de base sur un chef de parti ou sur le parti lui-même, alors j’ai conçu une série de questions où je demande, dans les deux langues, plusieurs questions liées à des enjeux ou des questions de société qui reviennent dans ce contexte (ce projet s’inspire beaucoup du travail fait par Vox Pop Labs, qui alimente la Boussole électorale de Radio-Canada, un outil qui aide les citoyens à trouver le candidat qui correspond le mieux à leurs valeurs).
Voici la cartographie globale des questions selon l’enjeu et la langue :
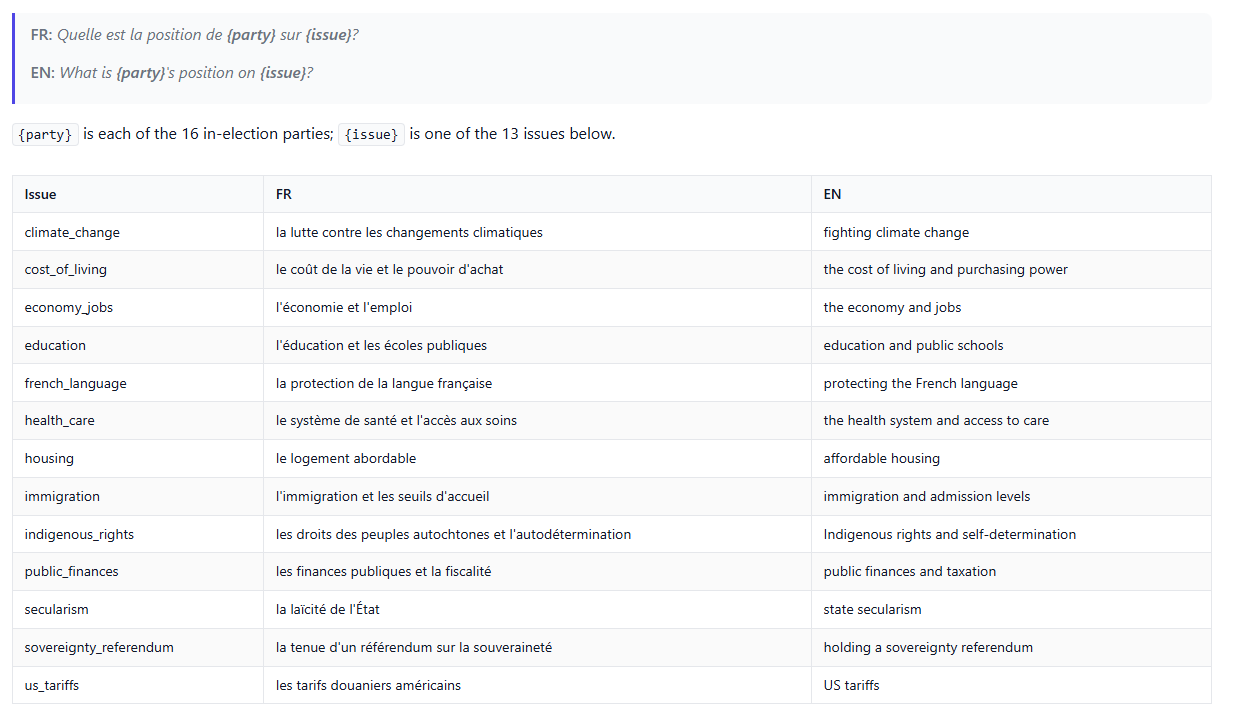
Pour collecter cette information, voici les endpoints que j’ai utilisés :
Chatgpt interaction
Le moteur chatgpt (docs) prend le prompt dans q, qui dans notre cas est la question elle-même. Le paramètre qui compte ici est web_search : mettez-le à true et ChatGPT fait des recherches web en direct avant de répondre, et vous récupérez les reference_links citées, l’ensemble complet des web_results, et les search_queries qu’il a réellement exécutées, donc vous voyez ce qu’il a cherché et pas seulement ce qu’il a répondu.
PS : j’ai aussi mis en place un pipeline Gemini pour collecter les réponses de l’agent Gemini, mais malheureusement, j’ai oublié d’activer la recherche web. Je partage quand même le code ci-dessous (même endpoint, juste en changeant l’agent derrière)
Gemini interaction
Avec cette information, on peut facilement comparer à quel point les réponses se ressemblent, pour détecter des affinités entre partis sur un sujet précis. J’ai construit une petite carte PCA (anglais vs français, par enjeu) qui trace la réponse de chaque parti jour après jour, pour voir quels partis se rapprochent et lesquels se démarquent. Le processus est simple : j’ai utilisé ibm/granite-embedding-97m-multilingual-r2, puisqu’il se classe bien sur le leaderboard MTEB et tourne facilement sur ma propre machine. Je crée l’embedding de chaque réponse le premier jour, je construis une projection PCA à partir de cette journée-là, puis je ré-encode la réponse de chaque nouvelle journée et je la projette dans l’espace PCA d’origine. Voici à quoi ça ressemble pour la question du référendum sur la souveraineté :
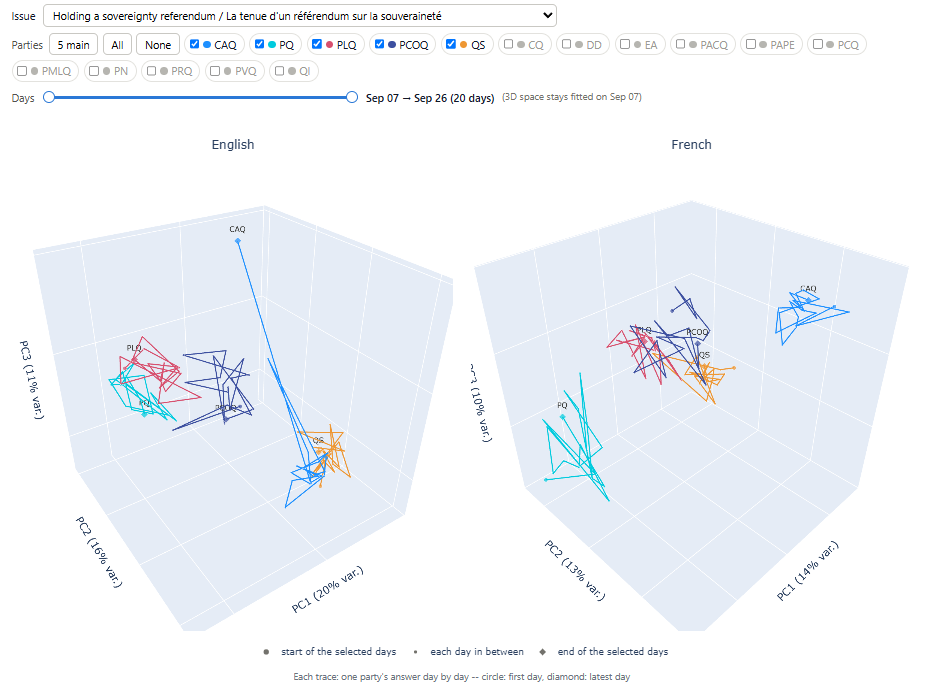
Dans le graphique lié à la question du référendum sur la souveraineté, on voit clairement deux choses :
- Le point isolé de la CAQ dans le graphique anglais vient d’une réponse par défaut de ChatGPT, sans vraiment de contenu, essentiellement une réponse toute faite :
I'll check the party's current official position and recent statements, since this can change over time. - Un clivage pro-référendum contre anti-référendum, avec QS et le PQ qui veulent tous les deux une forme de référendum, mais avec une saveur différente (le PQ veut l’indépendance, alors que QS penche plus vers plus d’autonomie en tant que province), face au PLQ, à la CAQ et au PCOQ, qui ne veulent pas du tout tenir de référendum.
Au-delà des réponses de ChatGPT, il est aussi intéressant de voir les sources utilisées pour les construire. Comme SearchAPI expose exactement ce que la recherche web a retourné, j’ai cartographié les sources utilisées jour par jour dans une heatmap. Ça s’est aussi avéré être un sujet un peu délicat, selon un article récent de Radio-Canada.
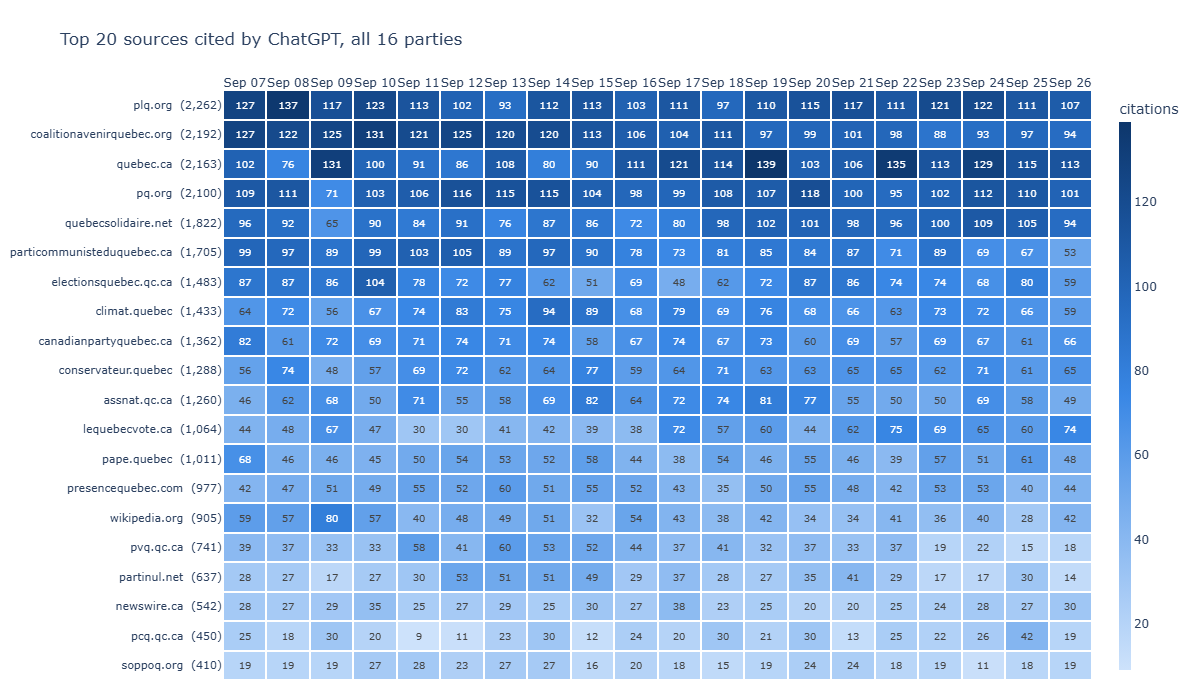
On voit clairement que la source la plus utilisée est soit le site du parti lui-même, soit electionsquebec.qc.ca, mais il y a aussi ce site, lequebecvote.ca, qui revient régulièrement. Il a fait les manchettes récemment : le site utilise l’IA pour générer son contenu, et ce contenu s’est avéré erroné, donc par ricochet, les réponses de ChatGPT qui le citaient étaient aussi erronées, durant un audit qui a eu lieu entre le 10 et le 11 septembre. Dans ma carte, on voit clairement le nombre de citations baisser un peu pendant l’audit avant de remonter à des chiffres plus élevés par la suite 🤔.
Et voilà pour la dernière des sources utilisées dans cette exploration de l’élection québécoise à venir, avec l’aide du service SearchAPI.
Mot de la fin
Ça a été une expérience amusante d’explorer ces nouvelles sources de données, et ça m’a rappelé mes débuts dans des projets de data science autour des données Twitter. Dans l’ensemble, mon expérience avec SearchAPI a été plus que positive. J’ai vraiment apprécié la facilité de mise en place et la fiabilité du service, et ça m’a clairement donné de nouvelles idées autour de la collecte de données et de l’analytique, et pas seulement ça.
Si vous êtes curieux de jeter un œil aux données que j’ai collectées, vous pouvez les trouver dans le dataset Kaggle. Je n’ai fait qu’effleurer la surface de ce qui est possible avec, donc n’hésitez pas à creuser et à partager vos observations. Je prévois continuer à collecter des données jusqu’à la fin de l’élection et un peu au-delà, donc le 9 octobre devrait être ma date finale.
J’essaie aussi de garder une version à jour de certaines des visualisations présentées dans ce rapport HTML (propulsé par Briefing) sur mon site.
J’espère que cette lecture vous a plu, et n’oubliez pas d’aller voter ! 😉
Références
- Dataset de l’élection présidentielle française (2017) — Kaggle
- Dataset d’écoute en ligne de l’élection présidentielle française (2022) — Kaggle
- SearchAPI — searchapi.io
- searchapi-provincial-election-qc-2026 (dépôt) — GitHub
- Principaux chefs de parti du Québec (article) — CBC News
- Élections Québec — electionsquebec.qc.ca
- Section de données ouvertes du Québec — dgeq.org
- Biographie de François Legault — Assemblée nationale du Québec
- Coalition Avenir Québec — coalitionavenirquebec.org
- Documentation de l’API Google News — searchapi.io
- Documentation de l’API Google Rank Tracking — searchapi.io
- Documentation de l’API Google Trends Trending Now — searchapi.io
- Documentation de l’API Google Trends — searchapi.io
- Documentation de l’API ChatGPT — searchapi.io
- Vox Pop Labs — voxpoplabs.com
- Boussole électorale — Radio-Canada
- ibm-granite/granite-embedding-97m-multilingual-r2 — Hugging Face
- Article de Radio-Canada sur lequebecvote.ca — Radio-Canada
- lequebecvote.ca — lequebecvote.ca
- Quebec Election 2026 Search Attention dataset — Kaggle
- Briefing — PyPI
- Rapport en direct — auto-hébergé (AWS S3)
Citation
Si vous avez trouvé cet article utile, merci de le citer ainsi :
Daignan, Jean-Michel. (Sep 2026). Tracking the 2026 Quebec Election with SearchAPI on Google services & ChatGPT. the-odd-dataguy.com. https://www.the-odd-dataguy.com/en/blog/2026/09/26/searchapi-qc-election-2026/.
ou
@article{daignan2026searchapi,
  title   = {Tracking the 2026 Quebec Election with SearchAPI on Google services & ChatGPT},
  author  = {Daignan, Jean-Michel},
  journal = {the-odd-dataguy.com},
  year    = {2026},
  month   = {Sep},
  url     = {https://www.the-odd-dataguy.com/en/blog/2026/09/26/searchapi-qc-election-2026/}
}