Récap ACM RecSys 2026 : tendances, un explorateur de papiers et ma liste de lecture
Note : Cette version française a été générée par Claude Opus 5.5 (claude-opus-5-5) le 7 octobre 2026. La version originale en anglais est disponible ici.
Une nouvelle année, une nouvelle RecSys. L’édition 2026 vient de se terminer la semaine dernière à Minneapolis et, comme chaque année, je voulais faire mon récap, mais avec un bébé à la maison et les vacances qui approchent, le temps m’a manqué. J’ai donc un peu revu l’exercice, d’autant plus que ma façon de suivre la conférence a beaucoup changé depuis que j’ai commencé à la couvrir en 2020.
Cette année, le récap se fait en trois parties : une analyse de l’évolution de la conférence depuis 2007 (j’ai accumulé pas mal de données dessus ces dernières années), un outil que j’ai construit pour fouiller la conférence et son contenu, et enfin ma liste de lecture non exhaustive de papiers de l’édition 2026 à emporter en vacances.
État de la conférence ACM RecSys
Le rapport complet, avec plus de détails, est aussi disponible sous forme de rapport briefing dans mon espace public ICI, n’hésitez pas à fouiller dedans (et toutes les données utilisées pour le construire sont disponibles ICI).
Commençons par la vue d’ensemble : est-ce que la conférence continue de grandir, et qui y participe ? Ce premier exercice sert surtout à prendre la température de la conférence, et mon premier indicateur est le nombre de papiers publiés.
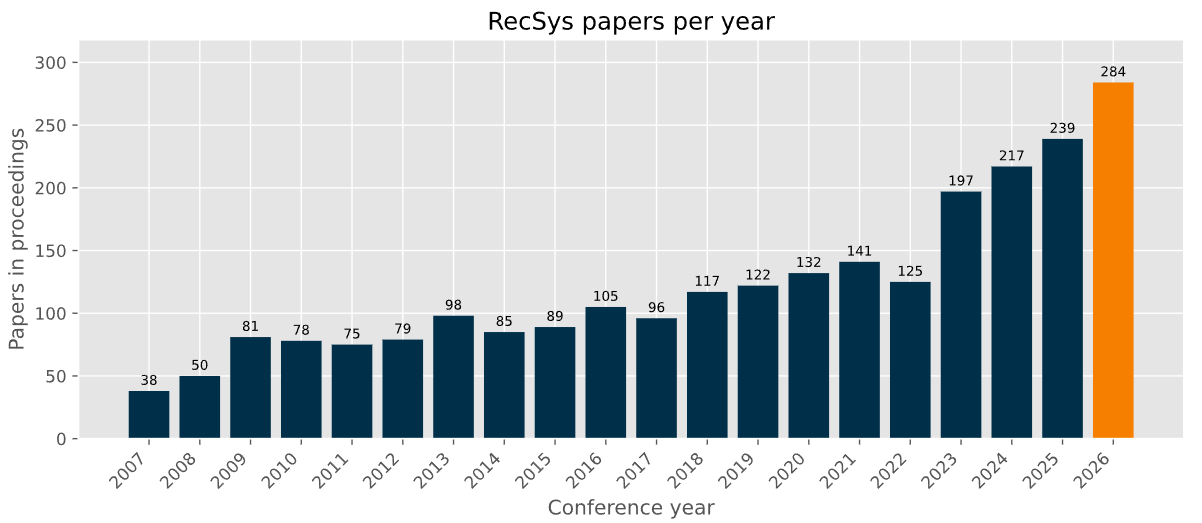
On en est actuellement à 284 papiers publiés (comptés à partir du fichier de citations), alors qu’il y a presque vingt ans, à la toute première édition en 2007, il n’y en avait qu’environ 38. La progression a été régulière, mais il y a une nette accélération entre 2022 et 2026. Je soupçonne que ça vient de l’assouplissement des règles de format des papiers et de l’ouverture de nouvelles tracks.
Cette croissance se voit aussi dans les listes d’auteurs : en 2007, un papier comptait en moyenne 2,4 auteurs, alors qu’en 2026 on est autour de 5,7. Le travail sur les systèmes de recommandation semble devenir plus collaboratif, à mesure que les systèmes deviennent plus complexes et exploratoires.
Si on creuse un peu plus et qu’on regarde les éditions les plus récentes, on commence à voir la répartition entre industrie et académie parmi ceux qui publient.
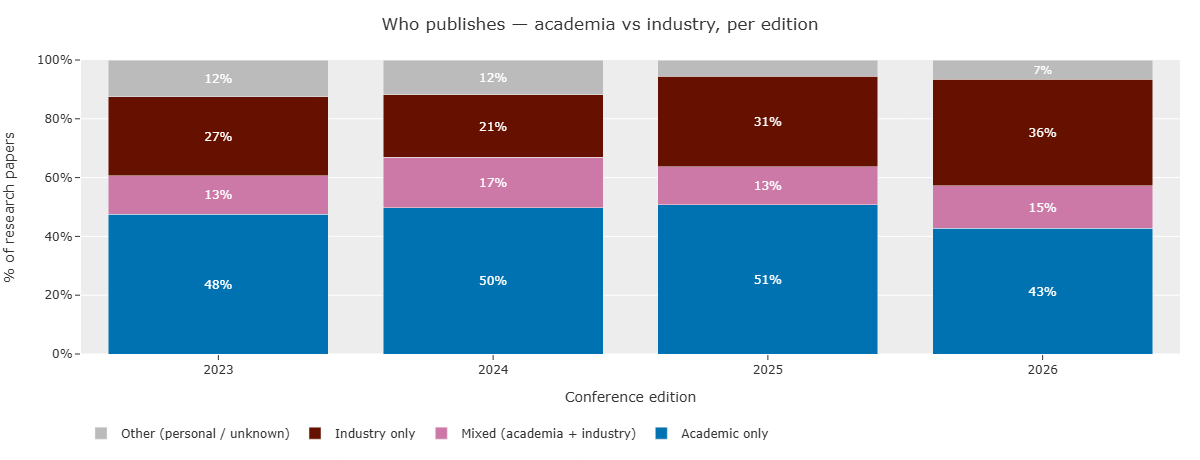
La répartition reste assez stable, avec environ la moitié des papiers venant de l’académie, mais la part de l’industrie augmente d’année en année. En 2026, les papiers avec au moins un auteur de l’industrie représentent aussi environ la moitié de l’édition. Pour moi, ça montre que la conférence devient plus que de la R&D purement académique : elle parle de plus en plus de systèmes qui apportent une vraie valeur dans l’industrie, où la percée se fait dans l’application concrète à grande échelle.
J’ai aussi compilé les principaux contributeurs de chaque domaine dans quelques graphiques. Vous les trouverez dans le carrousel ci-dessous, séparés entre académie et industrie.
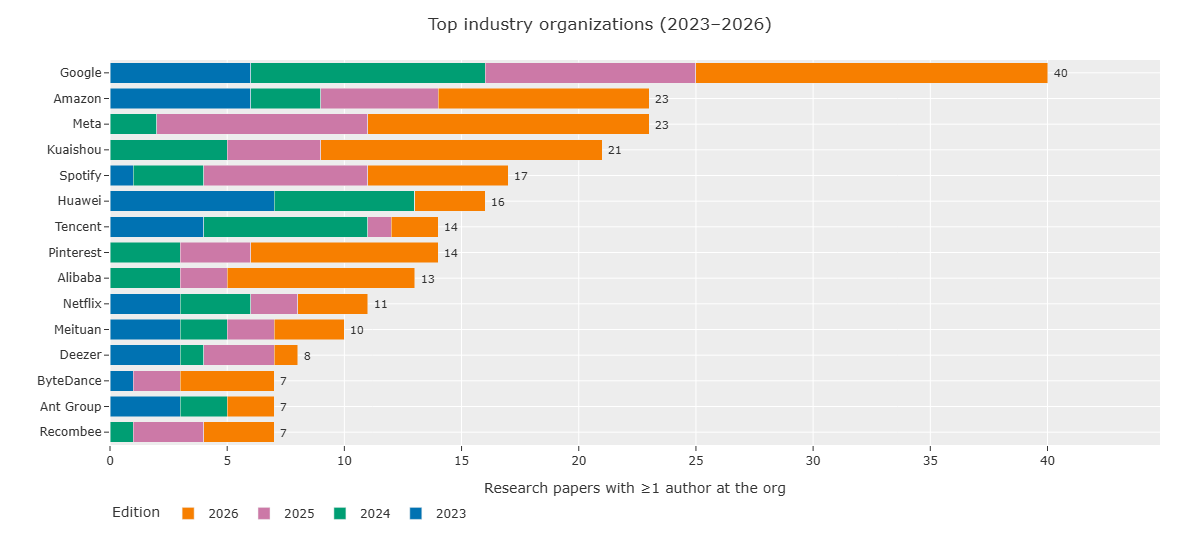
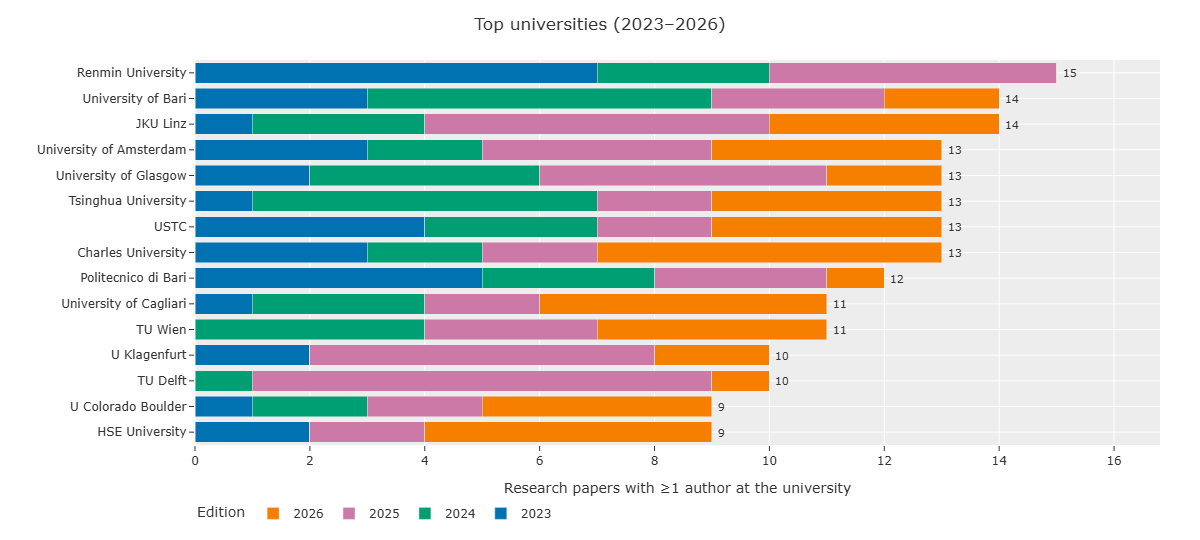
Google se démarque clairement comme l’un des principaux contributeurs industriels, mais en tant que Français, c’est toujours sympa de voir une entreprise comme Deezer tenir son rang juste en dehors du top 10, entourée de géants comme ByteDance et Netflix. Côté académique, l’université en tête semble être Renmin (en Chine), mais il y a un solide contingent européen juste derrière avec Bari(s), JKU Linz, Amsterdam et Glasgow.
Dans l’ensemble, il y a une foule variée qui parle de recommandation à cette conférence, et c’est clairement un bon endroit pour voir où vont les tendances dans les deux mondes.
En parlant de tendances, j’ai analysé les méthodes mentionnées dans ces papiers (avec un mélange de résumés par LLM et d’extraction de mots-clés), et il y a clairement eu un changement à la conférence, qui suit les grandes tendances de l’IA qu’on a tous observées ces dix dernières années.
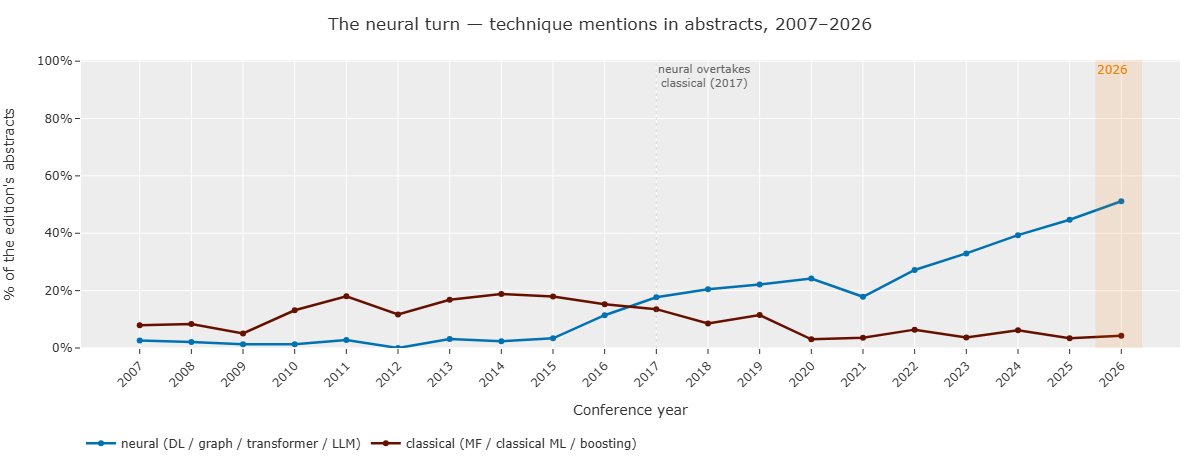
Vers 2017, il y a eu un vrai tournant : la part des papiers mentionnant des techniques neuronales comme le deep learning a dépassé celle des techniques classiques, et elle n’a fait qu’augmenter depuis. En 2026, plus de la moitié des résumés mentionnent une méthode neuronale. Si on sort notre loupe, on peut voir quelque chose de plus intéressant.
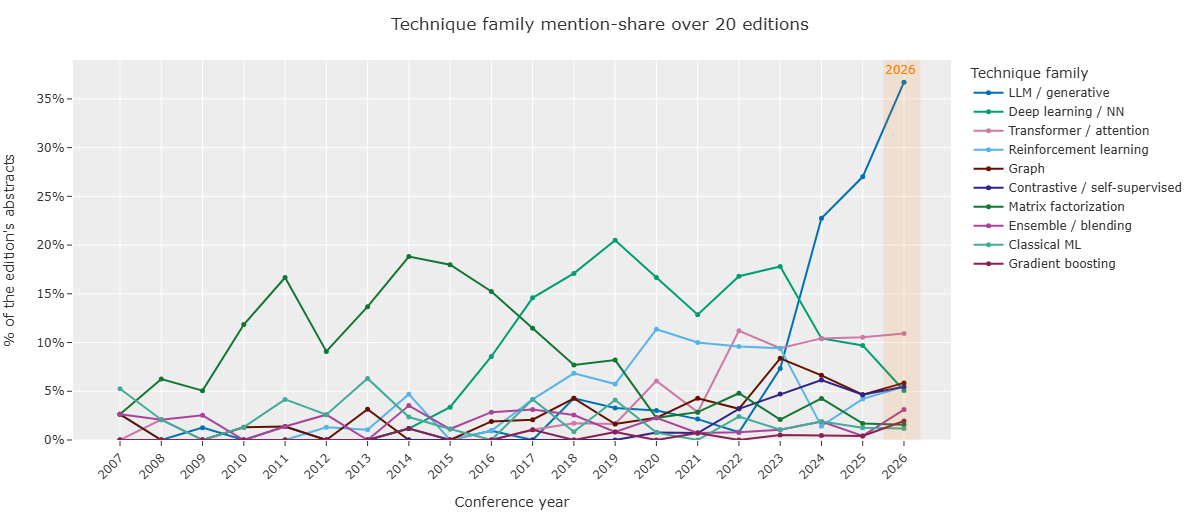
Le graphique rend le virage neuronal évident, mais on voit aussi un net changement d’intérêt depuis 2023 à l’intérieur du domaine neuronal. Avec les LLM et les techniques génératives qui s’invitent partout dans notre quotidien, cette famille a grimpé très vite, passant d’environ 7 % des résumés en 2023 à 37 % en 2026, ce qui en fait la famille la plus mentionnée de la conférence cette année. Si le début des années 2020 était l’ère des transformers, la seconde moitié de la décennie ressemble à l’ère LLM/générative, et on voit d’ailleurs la recherche et la recommandation se rapprocher depuis quelques années.
Tous ces graphiques viennent d’un projet perso sur lequel je bricole depuis un moment, alors laissez-moi vous montrer l’outil.
L’explorateur de la conférence RecSys
Ces dernières années, le format de la conférence a un peu changé : il n’est plus possible d’y assister à distance, maintenant que le monde a tourné la page de l’ère covid/télétravail. Ça a changé ma façon de consommer la conférence, puisque depuis 2021 j’y assistais à distance, en analysant les talks à la volée et en faisant mes récaps au fil de l’eau. Elle est restée hybride jusqu’en 2024 je crois, mais 2025 et 2026 étaient entièrement en présentiel, donc ma façon de la suivre a dû évoluer (ça, plus le fait que je suis maintenant parent, ce qui rend beaucoup plus difficile de passer des nuits blanches à regarder des talks et à enchaîner les résumés comme au bon vieux temps).
Dans ce contexte, et depuis 2023, j’ai commencé à télécharger tous les PDF de la conférence (ils sont librement accessibles pendant la période de la conférence) pour pouvoir les analyser après coup et faire mon récap plus à la carte, quand je trouve un peu de temps. Ce n’est pas tout à fait la même chose : on est moins en « mode conférence » à regarder les replays et écrire des récaps, donc c’est un peu moins motivant à certains égards.
Mais avec toutes les données que j’ai commencé à collecter depuis les PDF, plus toutes les métadonnées de citations librement accessibles et pleines d’informations intéressantes (voir la section précédente), je voulais construire quelque chose qui aille au-delà d’un simple suivi : un outil qui pourrait être utile à mes collègues chez Ubisoft, ou à toute personne intéressée par les systèmes de recommandation qui veut fouiller les papiers produits par la conférence.
J’ai donc construit une application web Gradio hébergée sur Hugging Face qui sert d’explorateur de la conférence RecSys, où j’expose les citations collectées pour chaque édition, plus les données que j’ai extraites avec Claude Haiku de tous les PDF rassemblés depuis 2023.
Avertissements :
- Cette application est totalement expérimentale et n’est en aucun cas approuvée par ACM RecSys, donc soyez indulgents.
- Je vous recommande fortement de ne pas utiliser l’application intégrée dans l’article (elle est trop petite) et de l’ouvrir plutôt directement sur Hugging Face.
L’idée générale est d’avoir un outil qui donne une vue d’ensemble des papiers de la conférence (la liste des papiers, leurs auteurs, résumés et liens), avec la possibilité de chercher et de parcourir le catalogue par le sens, de trouver des papiers similaires, de voir les connexions entre papiers RecSys (auteurs communs et citations, y compris les travaux externes qu’ils citent), et de creuser les organisations derrière les papiers pour voir comment leur présence et leurs intérêts évoluent dans le temps.
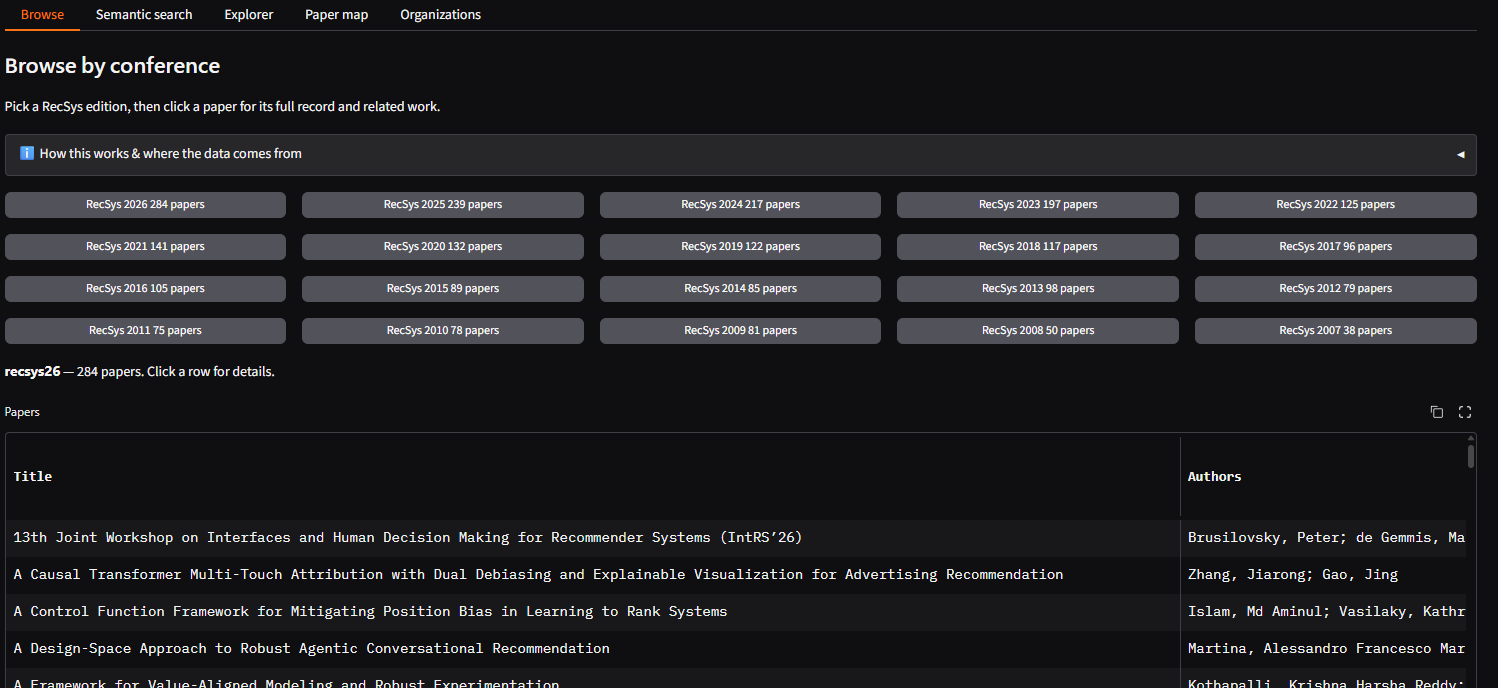
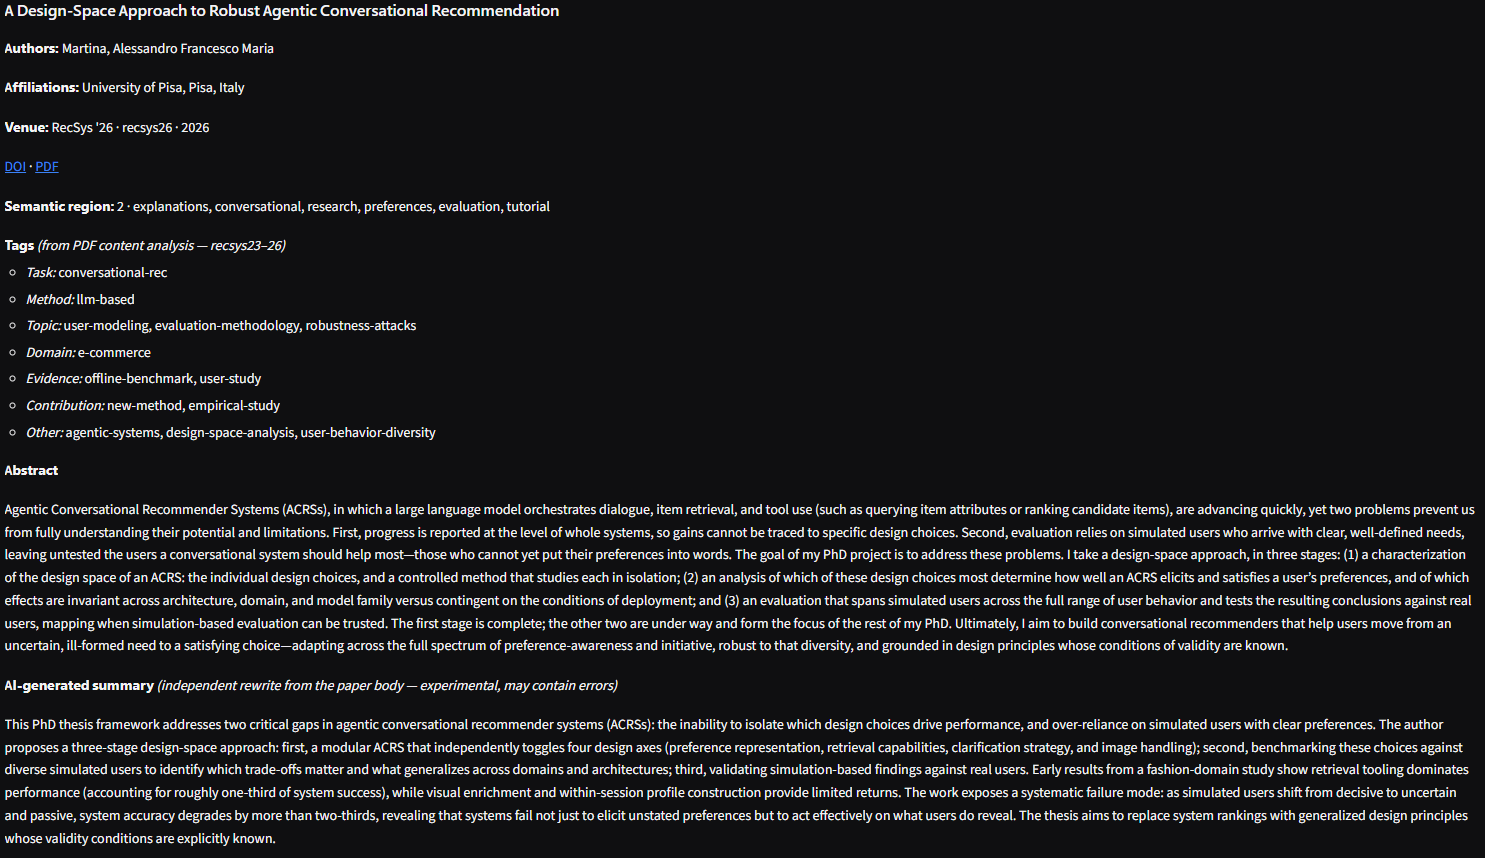
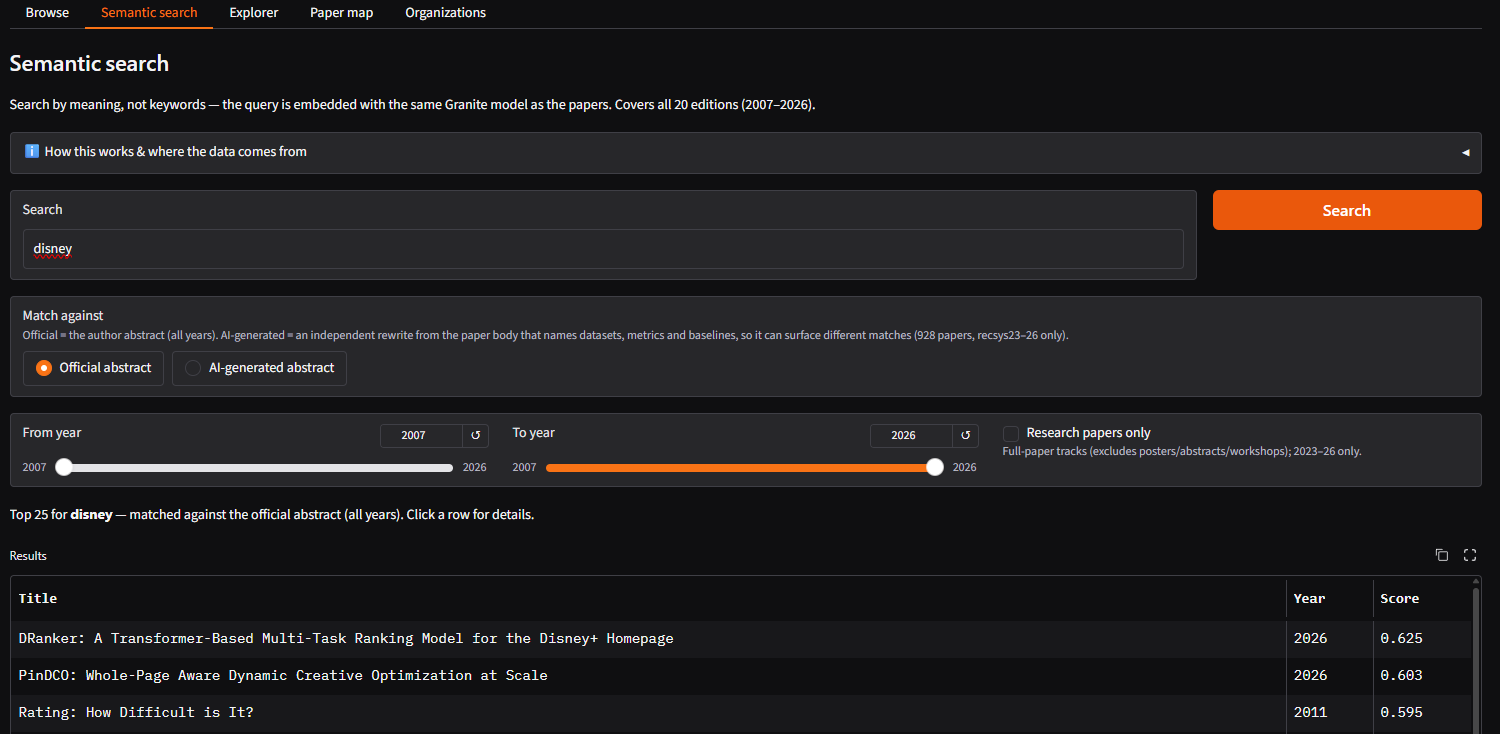
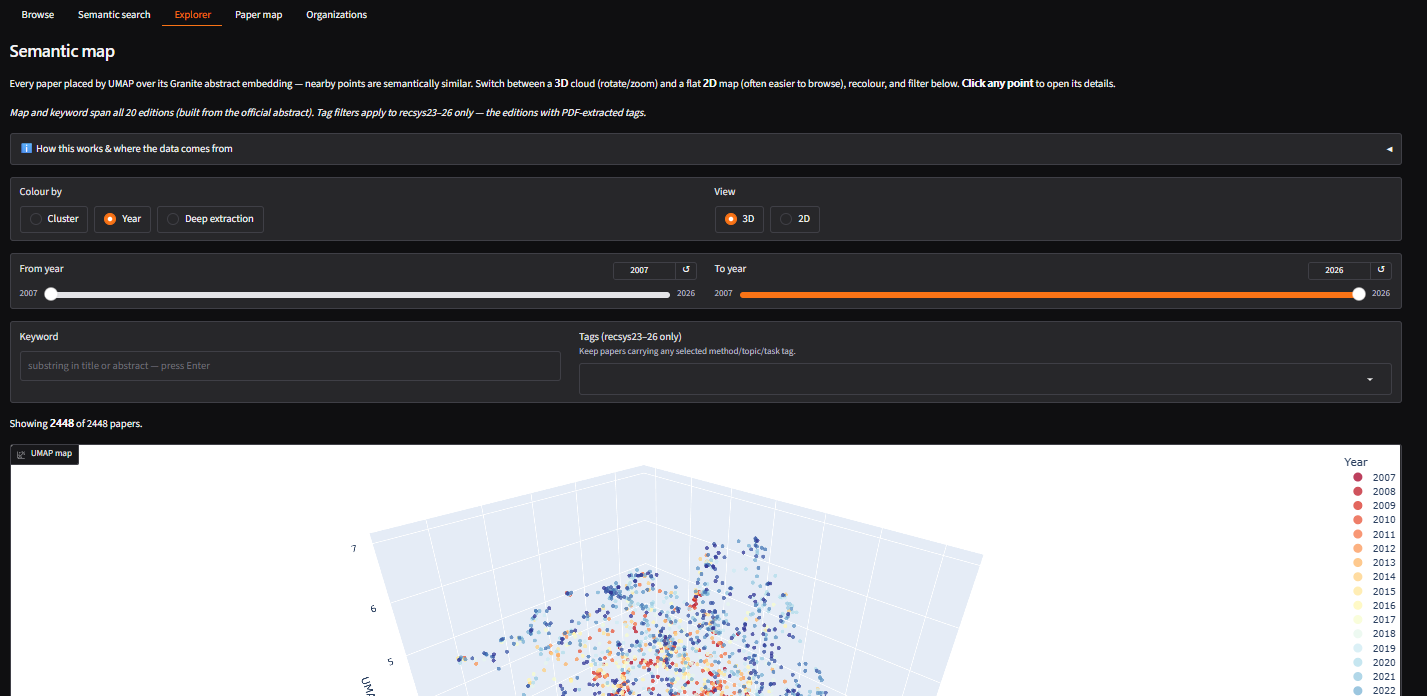
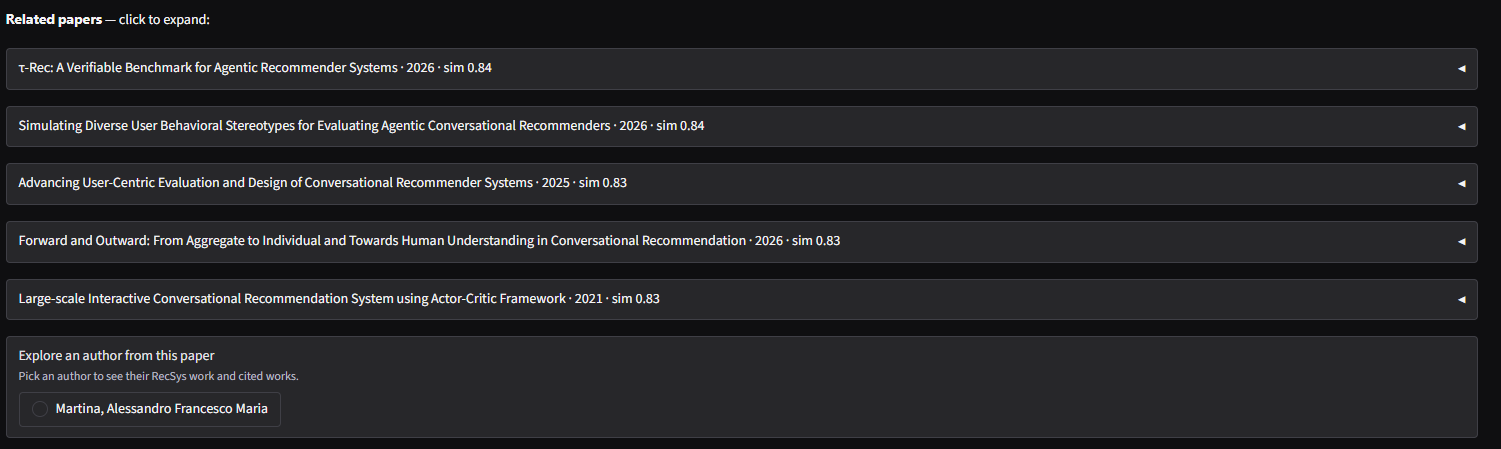
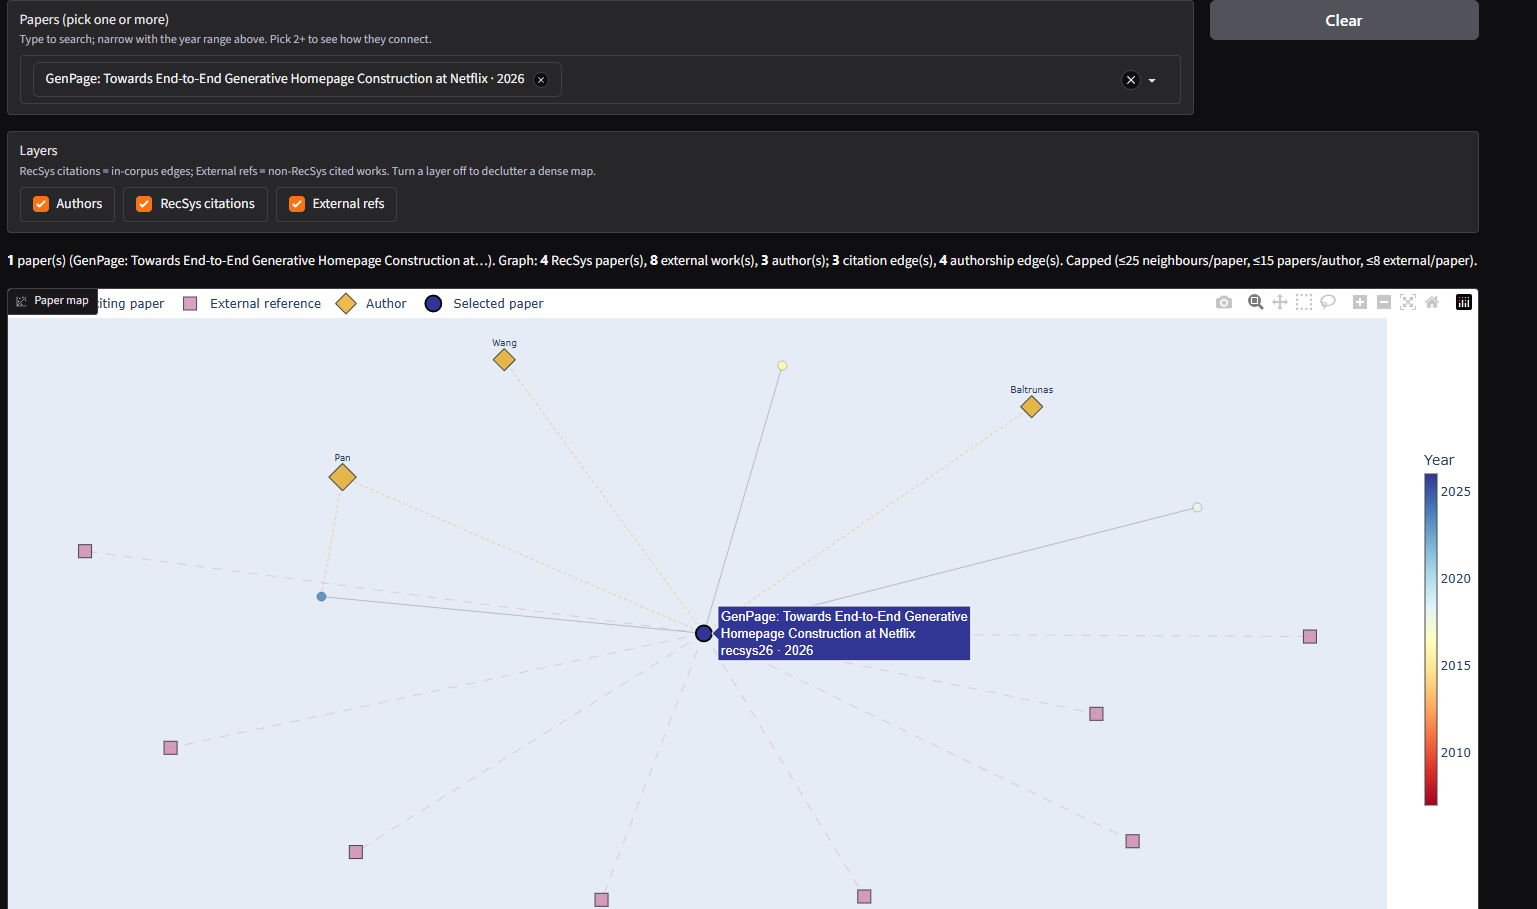
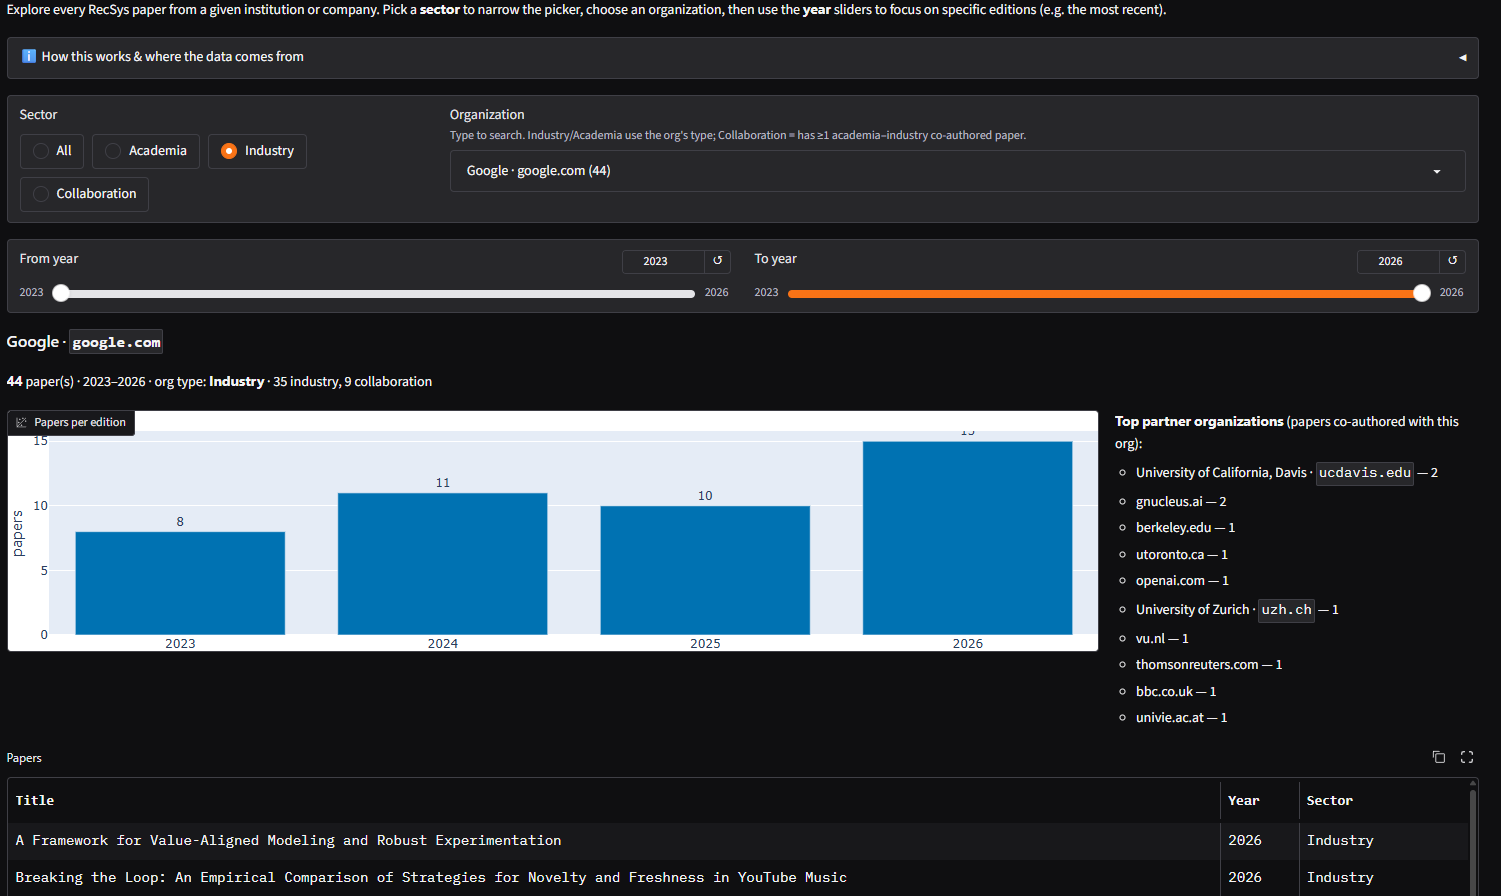
Ça m’a vraiment aidé à fouiller l’édition de cette année et à trouver rapidement du contenu aligné avec mes intérêts actuels en recommandation (métadonnées, retriever/ranker et usage des LLM/agents) en quelques clics, avec un peu de navigation, de la recherche sémantique et l’exploration des organisations.
Encore une fois, c’est une expérimentation avec Claude et l’outil va continuer d’évoluer, donc pour avoir les informations les plus à jour sur le projet, vous pouvez vous référer au README de l’application. Je suis aussi preneur de retours, alors n’hésitez pas à remplir ce formulaire Google. Les retours ont déjà amélioré l’application : merci à mes collègues qui l’ont testée, et un merci tout particulier à Bettina Hein, dont les idées ont inspiré quelques-unes des fonctionnalités ajoutées cette semaine.
Finissons donc par la partie la plus fun : mes favoris de lecture 2026.
Ma liste de lecture
Voici la version condensée : tout ce que j’ai mis de côté en parcourant l’édition de cette année dans l’explorateur, regroupé par thème, une ligne par papier. Attention, c’est biaisé vers mes intérêts du moment (représentations d’items et métadonnées, retrieval/ranking, et la vague LLM/agents).
Des LLM et des agents aux commandes de (presque) tout le pipeline
| Papier | Org | Sujet |
|---|---|---|
| Melo: A Production LLM-Powered Music Recommendation Agent | NetEase Cloud Music | Agent musical en production |
| RecEvolve: A Knowledge-Driven Autonomous Agent System | Recherche d’architecture auto-évolutive | |
| Personalized Recommendation Tool Learning via Autonomous Language Agents | UIC + Microsoft + Beihang | LLM comme routeur de modèles |
| LLM-Based User Personas for Recommendations at Scale | Google DeepMind | Personas d’intérêts par LLM |
| LLM-Based Re-Ranking for Real Estate Search | QuintoAndar | Re-ranker LLM |
| τ-Rec: A Verifiable Benchmark for Agentic Recommender Systems | Princeton + indépendant | Benchmark agentique |
Recommandation générative et semantic IDs
| Papier | Org | Sujet |
|---|---|---|
| GenPage: Towards End-to-End Generative Homepage Construction at Netflix | Netflix | Page d’accueil générative (m’a rappelé Brew360 de LinkedIn) |
| TubiFM: Unified Item, Carousel, and Search Ranking | Tubi | Ranking unifié par LLM |
| Codebook-Based Semantic IDs in Generative Recommendation | HSE University | Semantic IDs (position paper) |
Retrieval, ranking et représentations à grande échelle
| Papier | Org | Sujet |
|---|---|---|
| Multilingual Semantic Retrieval for Apple Music Search | Apple | Retrieval multilingue |
| End-to-End User and Item Embeddings | Amazon Music | Embeddings partagés retrieval/ranking |
| DRanker: A Transformer-Based Multi-Task Ranking Model | Disney | Ranker à base de transformer |
| Personalizing Incremental Video Search with Hybrid Text and ID Embeddings | Apple | Recherche sur préfixes courts (texte + ID) |
| Understanding ID-Text Complementarity in Sequential Recommendation | Snap | Ensembling ID vs texte |
Découverte, exploration et ce qui fait une « bonne » reco
| Papier | Org | Sujet |
|---|---|---|
| There’s Something About You: Epistemic Recommendation for Latent Interest Discovery | Disney | Exploration épistémique |
| Music Discovery Quality and the Value of Familiarity | JKU Linz + Deezer | Découverte par la familiarité |
| Personalized Fashion Discovery via Session Trajectories and Soft Negatives | TU Wien | Soft negatives de session |
Outils open source et reproductibilité
| Papier | Org | Sujet |
|---|---|---|
| Perseus: A Demo of Modular Personalization over Heterogeneous Event Sequences | T-Tech + ITMO | Framework modulaire de séquences d’événements |
| Scikit-Rank: Scikit-learn-Compatible Neural Ranking Models | T-Tech + HSE | Ranking neuronal façon sklearn |
| scikit-rec: A Unified, Extensible Recommendation Library | Intuit | Librairie de reco unifiée |
| StreamlitRecommenders: Recommendation Inspectability as a Reproducibility Standard | Charles University + Recombee | Démos d’inspectabilité |
| Transformer-based Sequential Recommender Systems | Spotify + Astra | Tutoriel |
Mot de la fin
Voilà pour ce premier tour de la conférence RecSys 2026. J’ai pris une route un peu différente pour le récap de cette année, mais ça m’a donné de nouveaux outils et une nouvelle série de papiers à explorer, alors attendez-vous à quelques futurs articles qui creuseront les papiers que j’ai sélectionnés.
Pour les aficionados les plus hardcore de RecSys : vous aurez remarqué que j’ai mis de côté le RecSys Challenge sans vraiment en parler. C’est volontaire. J’aimerais construire un article ou un projet dédié autour, puisque le Challenge capture généralement certaines des techniques les plus intéressantes du moment pour résoudre un problème précis, donc je veux prendre le temps de bien m’y plonger.
Références
- Récap RecSys 2020 — the-odd-dataguy.com
- Briefing — PyPI
- Rapport briefing sur l’état de RecSys 2026 — auto-hébergé (AWS S3)
- Explorateur de la conférence RecSys (application Gradio) — Hugging Face Spaces
- Données de l’explorateur de la conférence RecSys — Hugging Face Spaces
- README de l’explorateur de la conférence RecSys — Hugging Face Spaces
- Formulaire de retours sur l’explorateur — Google Forms
- Brew360 de LinkedIn — arXiv
Les papiers RecSys 2026 de ma liste de lecture ne sont pas repris ici, vous trouverez leurs liens directement dans les tableaux ci-dessus.
Citation
Si vous avez trouvé cet article utile, merci de le citer ainsi :
Daignan, Jean-Michel. (Oct 2026). ACM RecSys 2026 Recap: Trends, a Paper Explorer & My Reading List. the-odd-dataguy.com. https://www.the-odd-dataguy.com/en/blog/2026/10/07/state-recsys-26/.
ou
@article{daignan2026recsys,
  title   = {ACM RecSys 2026 Recap: Trends, a Paper Explorer & My Reading List},
  author  = {Daignan, Jean-Michel},
  journal = {the-odd-dataguy.com},
  year    = {2026},
  month   = {Oct},
  url     = {https://www.the-odd-dataguy.com/en/blog/2026/10/07/state-recsys-26/}
}